実験レポートの図と表を、同じCSVから作り直せるようにしておくと、数字を直すたびに別々のファイルを編集する手間を減らせます。
僕が公開しているlab-report-frameworkには、架空のソート実行時間を集計し、表・グラフ・文章を書く枠を入れた骨格PDFへつなげるサンプルがあります。この記事では、そのサンプルを手元で動かす手順を説明します。
到達点は、公開サンプルから骨格PDFを再生成し、CSV・集計結果・図表のつながりを確認することです。後半ではCSVのコピーを1か所変え、平均値が変わる一方、古い確認記録のままではPDF生成が止まることも試します。
使うのは、公開リポジトリに含まれる架空データだけです。大学の実レポートや実験データは掲載していません。制作の背景は、実験レポートの本文と、図表・組版の作業を分けた話にまとめています。
最初に確認:このサンプルで作れるもの
入力はtimings.csvです。入力サイズ4条件、アルゴリズム2種類、各5回の計40行を集計します。このCSVは実際の性能測定の証拠には使えません。
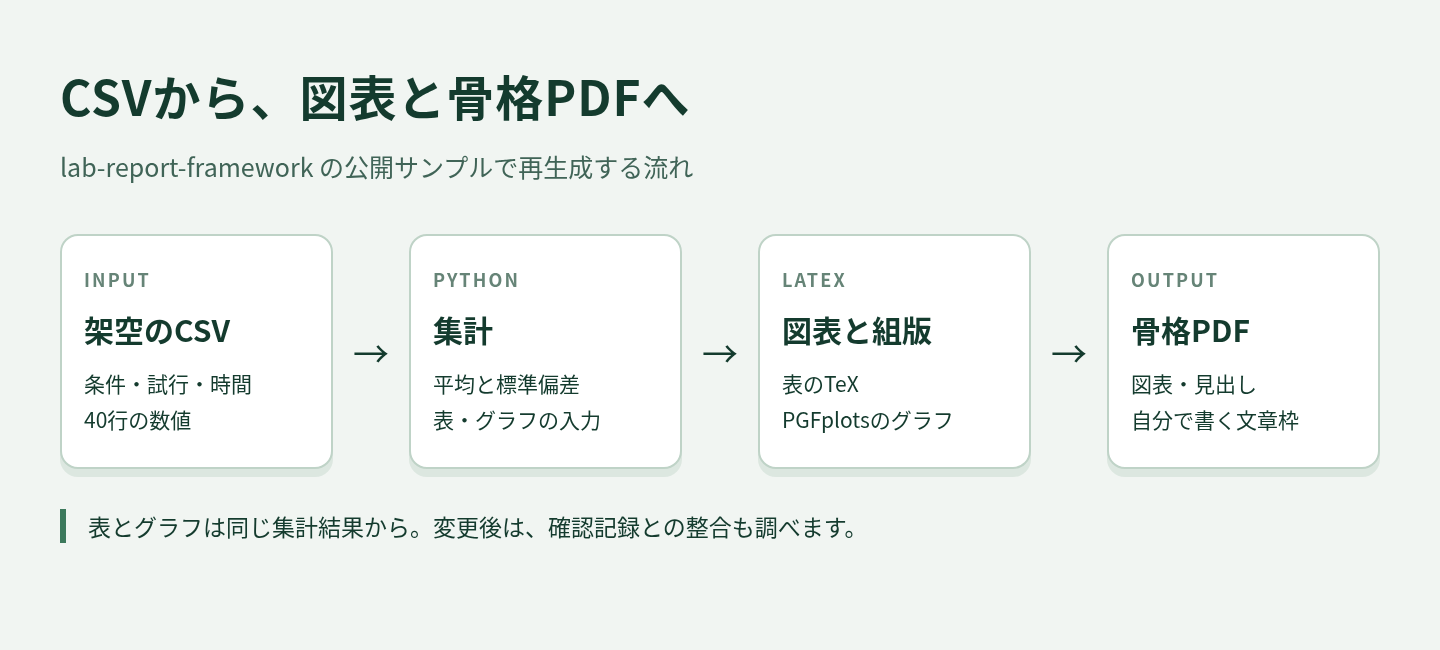
- Pythonが、条件ごとの平均値と標本標準偏差を計算します。
- 同じ集計結果から、確認用CSV、表のTeX、グラフ用の数値ファイルを作ります。
- LaTeXが数値ファイルを読み、図表と文章枠の入ったPDFを作ります。
この例のグラフを描くのはPGFplotsというLaTeXのパッケージです。Pythonは集計とファイル出力を担当します。Matplotlibで画像を保存して貼り付ける方式ではありません。
既存サンプルを再生成するだけなら、Codexとの対話は必須ではありません。まずコマンドで入出力を確かめると、あとでCodexへ作業を依頼するときも「何を変更したか」を追いやすくなります。
1.Python・Git・日本語LaTeXを準備する
必要なのは、Git、Python 3.10以上、日本語を扱えるTeX環境です。PDF生成にはlatexmkとlualatexを使います。
PythonやTeXが未導入なら、Pythonの公式ダウンロードとTeX Liveの公式導入案内から使用OSの手順を確認してください。macOSにはMacTeXの案内があります。この記事は、これらを利用できる端末から始めます。
今回の再検証は2026年10月13日、Linux・Python 3.12.14・latexmk 4.86・LuaHBTeX 1.18.0で行いました。Windows/macOSの導入画面や、新規インストール全体は検証していません。
lualatexが見つかるだけでは、日本語PDFを作れるとは限りません。今回も最初は日本語クラスなどが不足していました。エラーの見方は後半で説明します。
2.公開リポジトリを、練習用の新しいフォルダへ取得する
ターミナルを開き、作業用フォルダを置きたい場所で実行します。すでに作業中のリポジトリがある場合も、今回は別の名前で取得してください。
git clone https://github.com/Juuuuun8/lab-report-framework.git lab-report-csv-demo
cd lab-report-csv-demo
git checkout --detach cdded06e3103820947b003654887eff42dca0680最後の行で、この記事の検証に使った版へ合わせます。detached HEADという案内が出ても、この読み取り・実行用のコピーでは問題ありません。最新版には変更が入る可能性があるため、最初の再現では版をそろえます。
以下のコマンドは、AGENTS.mdとscriptsが見えるリポジトリの直下で実行します。examples/sort-benchmarkへ移動して実行する手順ではありません。
Pythonの仮想環境と依存パッケージ
仮想環境を作ると、このサンプルに必要なPythonパッケージを他の作業から分けて置けます。
Windowsのコマンドプロンプト:
python -m venv .venv
.venv\Scripts\activate.bat
python -m pip install -r requirements.txt
macOS/Linuxのターミナル:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt以降は仮想環境を有効にした状態でpythonを使います。簡易診断を実行してください。
python scripts/doctor.py --quickPython依存とPDF生成コマンドの項目がOKになり、最後に「利用可能です(簡易)」が出れば、この確認は完了です。簡易診断は、すべてのTeXパッケージやPDFの完成状態まで確認するものではありません。
3.CSVを読み、表とグラフの入力を再生成する
最初に開くファイルは、examples/sort-benchmark/data/raw/timings.csvです。先頭部分は次の形になっています。
n,algorithm,trial,elapsed_ms
1000,bubble,1,3.08
1000,bubble,2,3.16
1000,bubble,3,3.12
1000,bubble,4,3.10
1000,bubble,5,3.14nは入力サイズ、algorithmはアルゴリズム、trialは試行番号、elapsed_msはミリ秒の値です。まずは変更せず、次を実行します。
python examples/sort-benchmark/analysis/analyze.py
python scripts/reproduce.py verify examples/sort-benchmark
1行目は成功してもメッセージを出しません。2行目で次が出ることを確認します。
PASS: analysis outputs reproduced exactlyこの確認では、保存されている生成物を照合したうえで、別の作業コピーから生成物を作り直し、内容が一致するかを調べています。
生成先は次の4ファイルです。表とグラフの数字を別々に手入力する必要はありません。
data/processed/summary.csv:平均・標本標準偏差・試行回数。report/generated/summary_table.tex:PDF内の表。report/generated/bubble.dat:バブルソートのグラフ入力。report/generated/quick.dat:クイックソートのグラフ入力。
上のパスは、いずれもexamples/sort-benchmark/からの相対パスです。
「成功と表示された」以外に、数字も確かめる
summary.csvの先頭には、次の行ができます。
n,algorithm,mean_ms,sd_ms,trials
1000,bubble,3.1200,0.0316,5
1000,quick,0.2340,0.0032,5バブルソートの入力サイズ1,000の平均は、(3.08 + 3.16 + 3.12 + 3.10 + 3.14) / 5 = 3.12です。元のCSVから手計算できる1行を照合すると、別ファイルを集計していた、といった取り違えに気づけます。
実装はPython標準ライブラリのstatistics.fmeanとstatistics.stdevを使っています。sd_msは標本標準偏差です。標準誤差や信頼区間を表す列ではありません。
4.図表と文章枠の入った骨格PDFを作る
集計結果の確認ができたら、次を実行します。
python scripts/build_report.py examples/sort-benchmark --mode skeleton途中にPASS: PHASE 0-5が表示され、そのあとにPDF生成へ進みます。初回はフォントの準備に時間がかかることがあります。
成功すると、次の場所にPDFができます。エクスプローラーやFinder、エディタのファイル一覧から開いてください。
examples/sort-benchmark/build/skeleton.pdfpreview/skeleton.pdfはリポジトリに保存済みの見本、build/skeleton.pdfは今回生成したものです。再生成できたかを確かめるときは、後者を開きます。
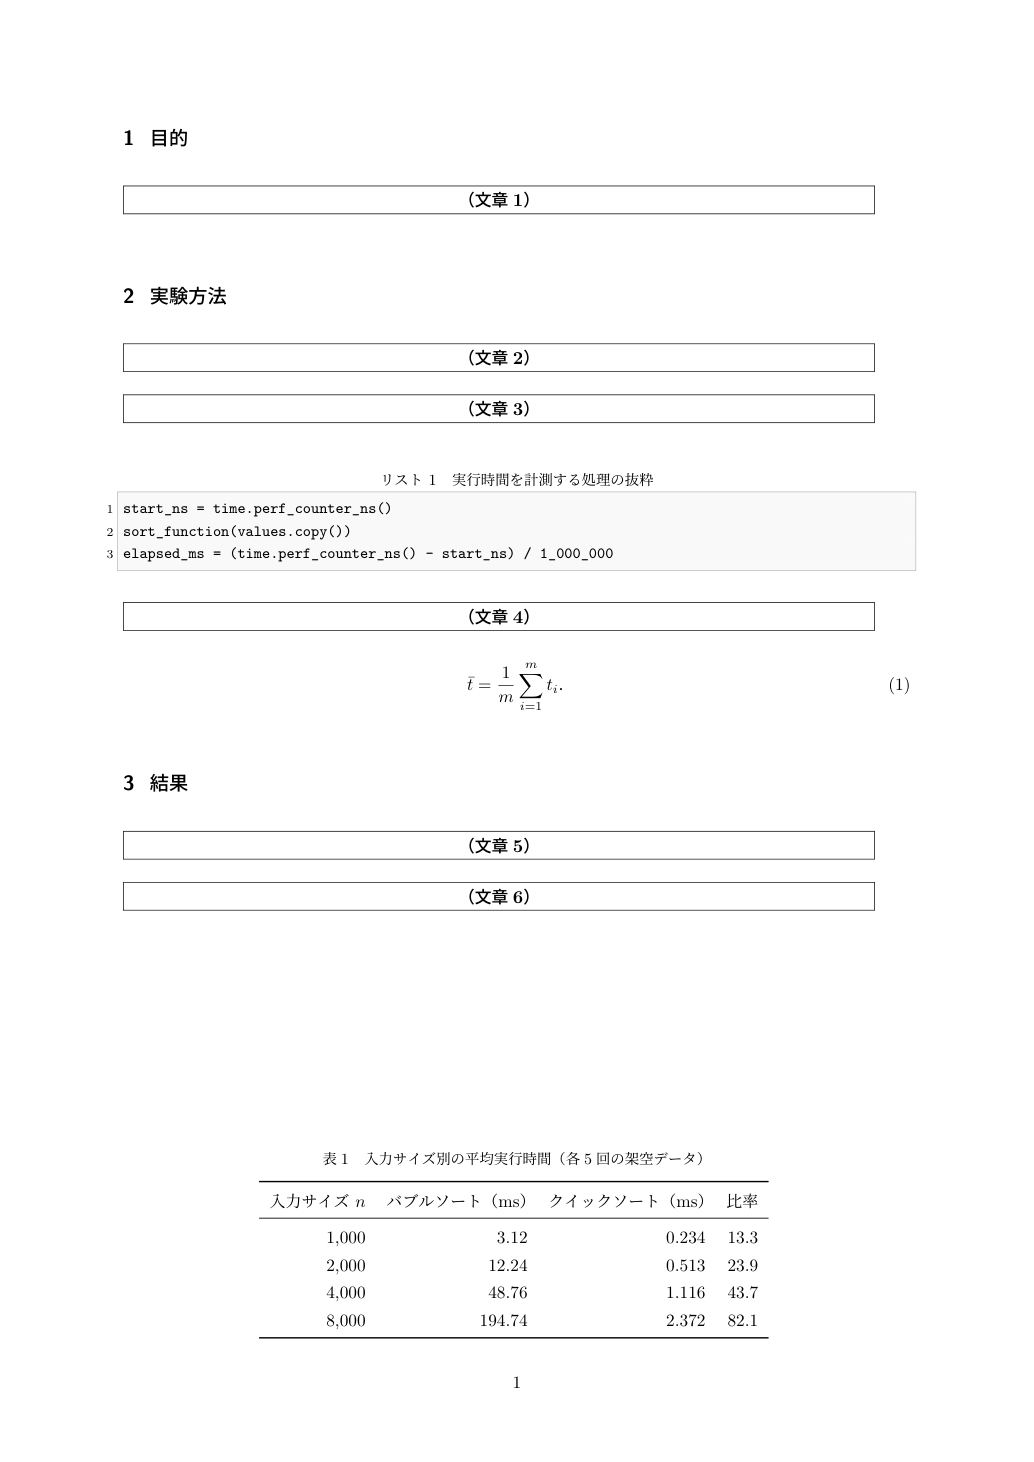
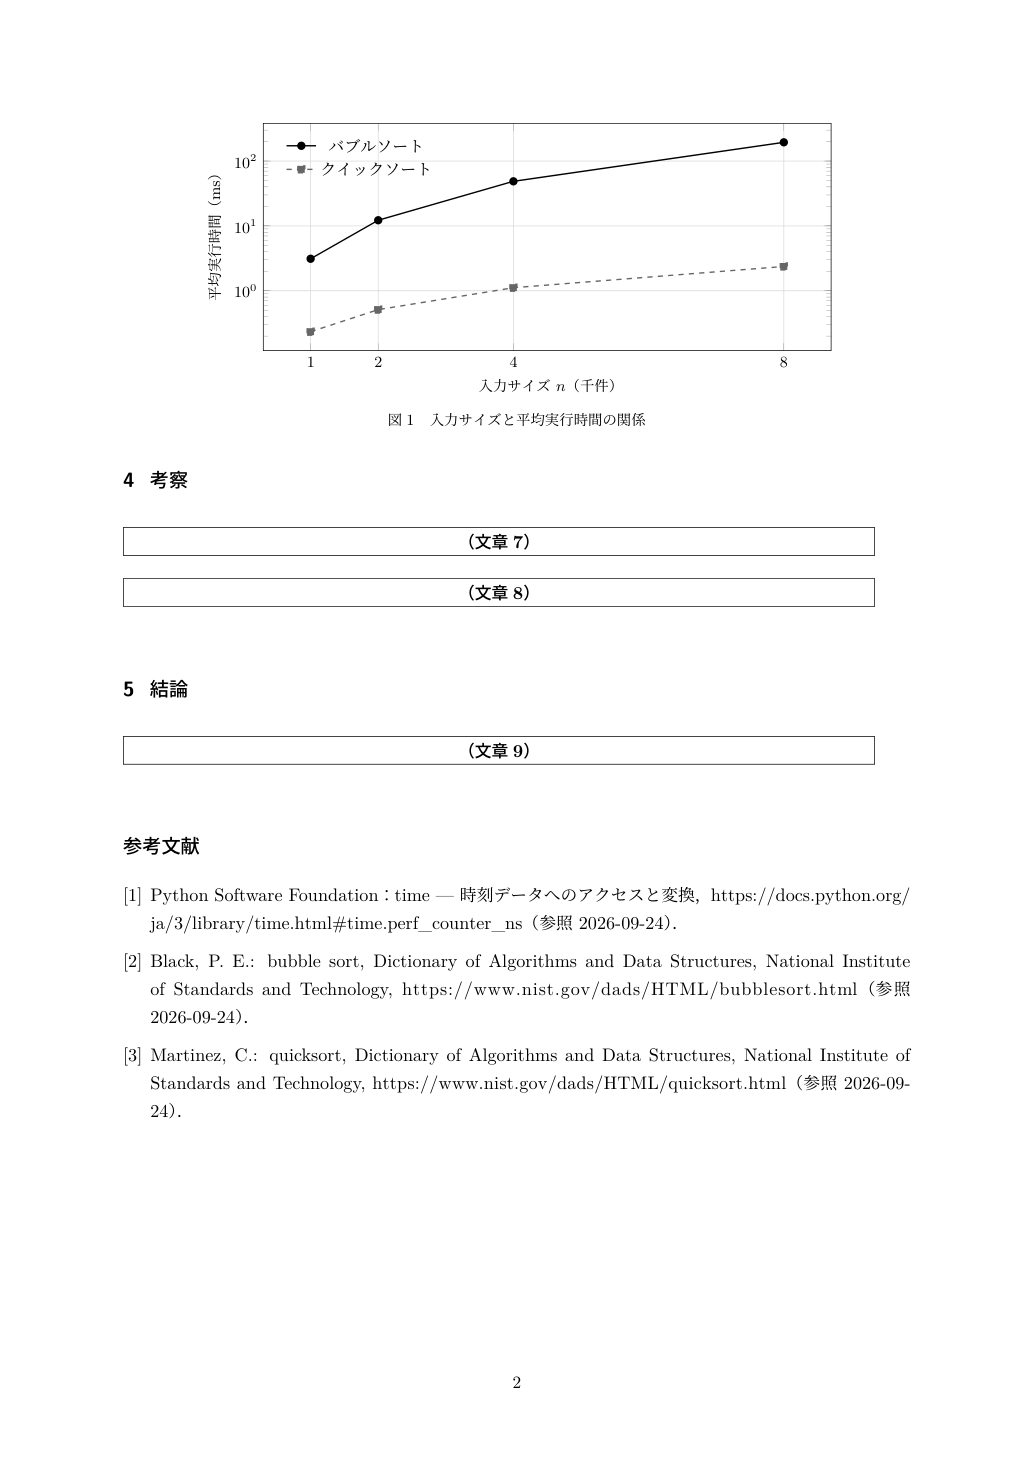
今回の出力は表紙を含めて3ページでした。PDFでは次を確認します。
- 日本語が文字化けせず、文章1〜9の枠が読める。
- 表の1,000行が、CSVの平均と対応している。
- グラフの軸名、単位、凡例が読める。
- 図表や参考文献が、ページの右端からはみ出していない。
この版の公開サンプルは、枠内が「文章1」のような表示です。枠の横に詳しい執筆内容が自動で印字される、という説明にはしていません。各枠の目的や必要な項目はspec/WRITING_PLAN.yamlにあります。
また、このサンプルには旧形式の確認記録が含まれるため、「課題別の学習範囲監査は未適用」という案内が出ます。PDFを生成できたことから、個別の授業の条件も満たしたとは判断できません。
5.CSVのコピーを1か所変えて、何が更新されるか見る
次は再生成の仕組みを見るための練習です。公開サンプルを別フォルダへコピーし、その架空データだけを変更します。実験で取得した生データを都合よく書き換える手順ではありません。
リポジトリ直下にtry_csv_change.pyを作り、次を保存してください。
from pathlib import Path
import shutil

source = Path("examples/sort-benchmark")
trial = Path("examples/sort-benchmark-csv-test")

if trial.exists():
    raise SystemExit("テスト用フォルダが既にあります。上書きせず終了します。")

shutil.copytree(source, trial, ignore=shutil.ignore_patterns("build", "__pycache__"))
raw = trial / "data/raw/timings.csv"
text = raw.read_text(encoding="utf-8")
before = "1000,bubble,1,3.08"
after = "1000,bubble,1,8.08"
if text.count(before) != 1:
    raise SystemExit("想定した行が1行ではありません。CSVを確認してください。")
raw.write_text(text.replace(before, after), encoding="utf-8", newline="\n")
print("架空CSVのコピーだけを変更しました:", raw)
実行すると、examples/sort-benchmark-csv-testというコピーができ、先ほどの5回分のうち1回目だけが3.08から8.08になります。
python try_csv_change.py
python examples/sort-benchmark-csv-test/analysis/analyze.pyコピー側のdata/processed/summary.csvを開くと、該当する平均が4.1200へ変わります。1個の値を5増やしたので、5個の平均は1増えました。
- 集計CSV:
3.1200→4.1200。 - 表のTeX:
3.12→4.12。 - グラフ用の
bubble.dat:1 3.1200→1 4.1200。 - 変更していないクイックソートの
quick.dat:内容は同じ。
表とグラフの入力を、同じ集計結果から作れていることが分かります。ただし、これで確認がすべて終わるわけではありません。
古い確認記録のままでは、PDF生成は止まる
コピー側で次を実行すると、今回の例ではエラーになります。
python scripts/build_report.py examples/sort-benchmark-csv-test --mode skeleton主な表示は次のとおりです。
FAIL: PHASE 0-5
- PHASE 3: raw data hash mismatch: data/raw/timings.csv
- PHASE 4: analysis output hash mismatch: data/processed/summary.csv
hash mismatchは、記録していたファイル内容と今の内容が一致しないという意味です。今回の変更では表とbubble.datにも同様のエラーが出ました。ここで新しい骨格PDFは生成されません。
たとえば平均だけが変わっても、すでに書いた文章に古い数値や解釈が残る可能性があります。集計の再実行と、変更後の内容の確認は別の作業です。
実レポートで修正する場合は、元データを保持し、変更理由、生成物、本文の参照、必要な確認記録をそろえ直します。エラーを消すことだけを目的に、確認した記録を手で書き換えないでください。この練習では停止するところまでを確認し、提出用の状態へ進めません。
つまずいたときは、止まった段階から確認する
Pythonのモジュールが見つからない
No module named yamlなどが出る場合は、仮想環境を有効にしているか確認し、同じPythonでpython -m pip install -r requirements.txtを実行します。pipだけで実行すると、別のPythonに入れてしまうことがあります。
日本語TeXクラスやパッケージが見つからない
今回の環境では、順にltjsarticle.cls、luatexbase.sty、siunitx.styの不足が見つかりました。日本語LaTeX、LuaTeX用パッケージ、理工系パッケージを補い、同じ骨格生成コマンドが通ることを確認しました。
不足ファイル名はexamples/sort-benchmark/build/latexmk-output.logに出ます。TeX Liveの導入方式に合うパッケージ管理機能で補います。Debian系のパッケージでは、それぞれtexlive-lang-japanese、texlive-luatex、texlive-scienceに対応します。Windows/macOSで同じパッケージ名のOSコマンドを使うわけではありません。
CSVの列名や文字コードを変えてしまった
この集計スクリプトは、列名がn,algorithm,trial,elapsed_msで、UTF-8のCSVであることを前提にしています。一般の実験データを、そのまま何でも取り込める読み込み器ではありません。
別の実験で使うときは、単位、列名、条件のまとめ方、欠測・除外の扱いを先に決め、分析コードを合わせます。今回の標本標準偏差の計算には、各条件で2個以上の値が必要です。
グラフが元の数字と違って見える
この例の横軸はn / 1000なので、CSVの1000はグラフでは1です。縦軸は対数目盛です。見た目だけで値の差を読まず、軸・単位・元の集計結果を合わせて確認してください。
自分のレポートへ進む前に
ここまでで確認したのは、公開サンプルのCSVを集計し、図表を含む骨格PDFへつなぐ手順と、データ変更が古い検査記録に対して検出されることです。完成稿の提出固定までを検証した記事ではありません。
自分の課題に使う際は、サンプルの実験条件や確認済み状態をそのまま引き継がず、教員の指定・AI利用規則・使用できる資料を確認して新規実験として進めます。本文は自分で書き、図表が自分の説明したい内容と対応しているかを確認します。
まずはbuild/skeleton.pdfの表とsummary.csvの1行を照合してみてください。「どのファイルの、どの数字が、この図表になったか」が分かると、Codexへの修正依頼も具体的になります。
作業の分担から確認したい場合はレポートの骨格づくりをCodexに任せるワークフローへ。自作の分析コードの変更を履歴に残したい場合は、GitHubへコードを保存する手順が次の入口になります。授業の資料や実データを公開リポジトリへ入れる前には、公開してよい範囲を確認してください。
確認した実装・公式資料
- lab-report-framework:検証した固定コミット
- 架空CSVを集計するanalyze.py
- 検査・生成物・確認記録の扱い
- Python公式:statistics
- PGFplots Manual:数値ファイルの読み込み
確認日:2026年10月13日。生成した骨格PDFは全3ページを画像で確認しました。OSやTeXの版が異なる場合、文字や改ページが完全に同じになるとは限りません。