Excelを生成AIに分析してもらいたい。でも、氏名や電話番号、取引先名まで渡したいわけではない。そんな場面に向けて、Excel・CSVの情報を端末内でマスキングするWebアプリ「MaskSheet」を作り、公開しました。
ただ、ファイルを読み込めて、置換した表を保存できるだけでは十分ではありませんでした。実務のExcelと具体的な指摘を通じて、表の読み取り方、操作の手間、対応表を取り違えたときの復元に問題が見つかりました。この記事では、v0.4.0までに何を直し、どこに限界を残しているかを紹介します。
先に使ってみたい方は、MaskSheetの架空データのサンプルから試せます。全機能無料・登録不要で、日本語と英語に対応しています。
AIに渡す前に、必要な情報と隠す情報を分ける
例えば売上の推移を調べたいなら、金額や来店回数は必要でも、氏名や連絡先は不要かもしれません。MaskSheetでは、列ごとに「保持・置換・削除」を選び、元ファイルを変更せず、新しいAI用のExcel・CSVを作ります。
氏名をすべて同じ文字へ置き換えると、どの行が同じ名前なのか分からなくなります。そこで、同じ種類・同じ文字列は、同じ出力内で一貫した記号へ置換するようにしました。複数シートでも同じルールを使います。ただし、同姓同名の別人を区別する機能ではありません。
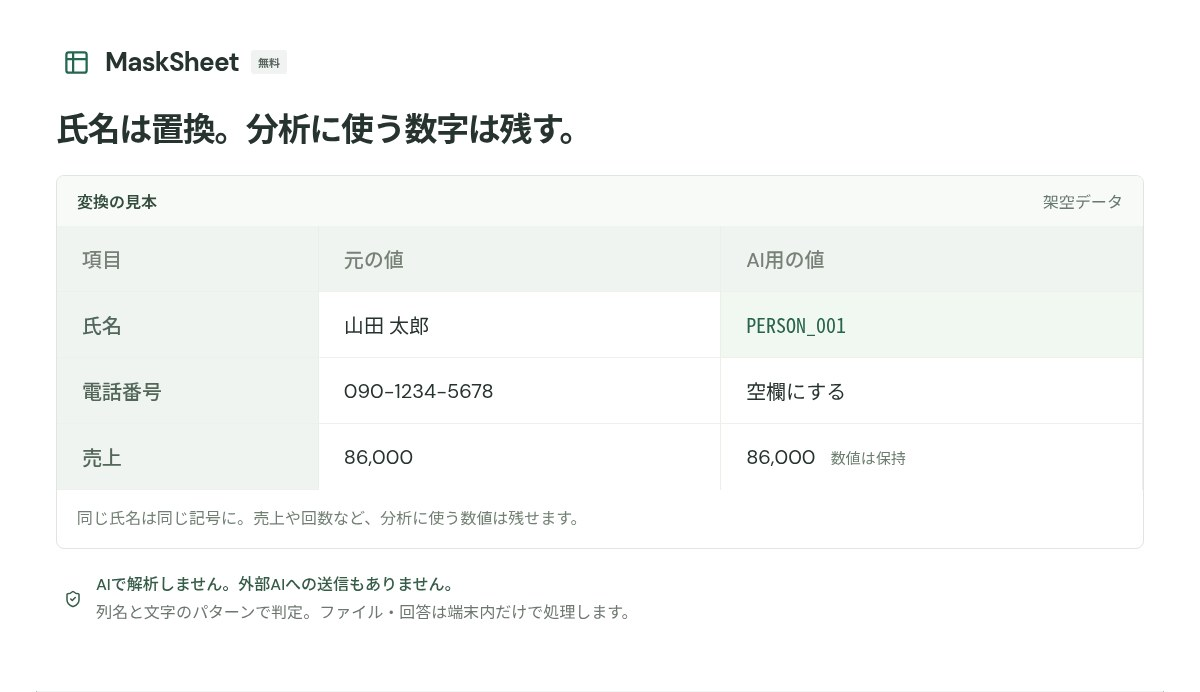
住所を市区町村までにする、生年月日を年齢へ変える処理も用意しました。分析に必要な粒度を選べる一方、削除した値、住所の省略部分、年齢に変換した日付は復元できません。
AIを使って開発したアプリですが、ファイルをAIで解析しません
開発ではAIを活用しました。僕が要望や問題点、実務のデータで起きた不具合を伝え、AIが設計・実装・テスト・公開作業を進める形で改善しています。
一方、MaskSheetの候補検出には、列名とセルの文字パターンを使います。外部のAIモデルやAI APIへファイルを渡して判定する構成にはしていません。対応形式もXLSXとCSVに絞り、解析・検出・変換・復元はブラウザ内で行います。
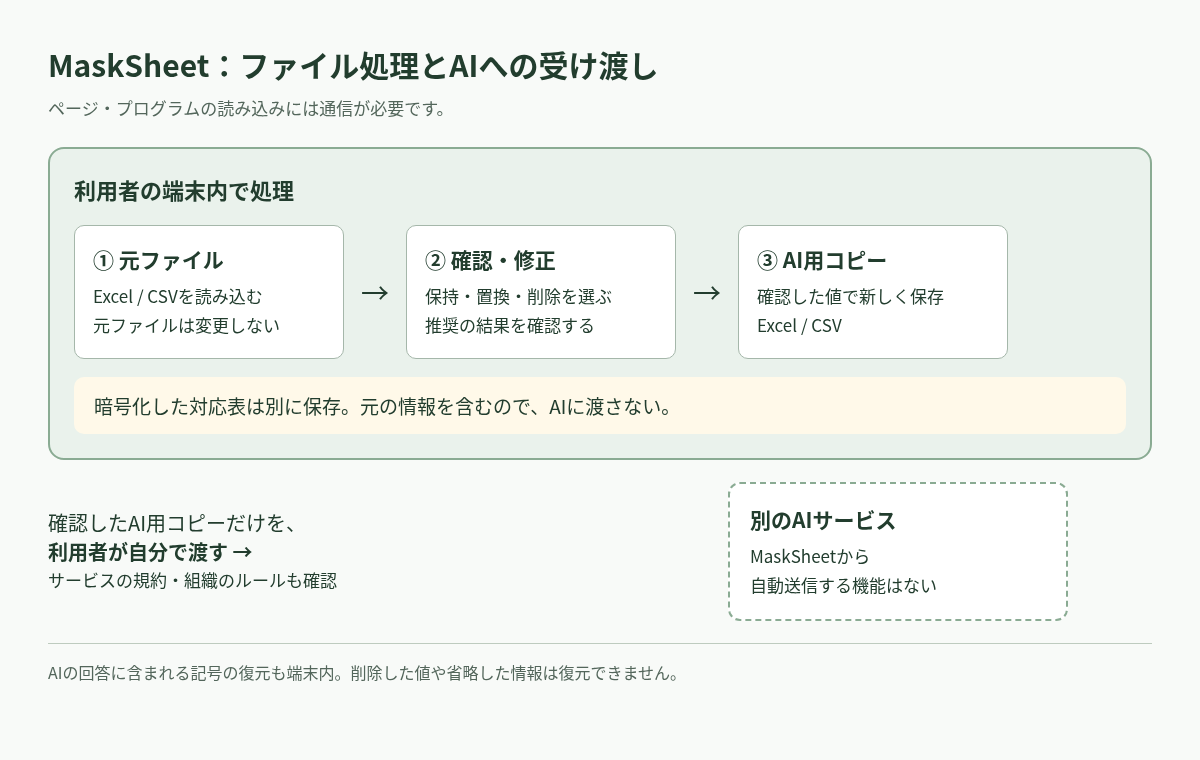
「AIを使って作ること」と「利用者のデータをAIで解析すること」は、分けて設計しました。AIとの開発の進め方は、初めてWebアプリを作ったときの記録でも紹介しています。
設定画面を増やすより、処理した結果を先に見せる
当初は、スキャン結果、列の設定、変換前後の確認を別画面にする構想でした。ところが開発中に、「利用者は設定を選びたいのではなく、処理した結果を確認したい」という指摘がありました。
そこで、操作を次の3段階にまとめました。
- 読み込む:Excel・CSVを選ぶ。
- 確認する:推奨処理を適用した表を見て、必要な列だけ変更する。
- 保存する:確認した内容で、新しいAI用コピーを作る。
複数シートも確認できます。自分のファイルを選ぶ前に試せる架空データのサンプルと、変換前後の見本を追加しました。ファイル選択の分かりやすさはiLovePDF、サンプルや比較への案内はCSVJSONを参考にしています。
白と深い緑を基調に、日本語にはNoto Sans JP、英数字にはDM Sansを使いました。フォントはアプリと一緒に配信し、利用中に外部のフォントサービスへ取りに行く構成は避けています。
実務のExcelで、氏名が隠れなかった
最初の設計の弱点がはっきりしたのは、実際の成績比較表を読み込んだときでした。氏名がマスキングされなかったのです。
原因は、先頭行を無条件に列名として扱っていたことと、値から人名を判断する根拠が不足していたことでした。表は、1行目がタイトル、2〜3行目が二段の見出し、4行目以降がデータという構造です。「氏名」という本当の見出しを認識できていませんでした。
| 行 | 実務の表にあった内容 | 最初の設計での問題 |
|---|---|---|
| 1行目 | 表のタイトル | 列名として扱ってしまう |
| 2〜3行目 | 二段の見出し | 「氏名」などを見出しとして認識できない |
| 4行目以降 | 氏名・成績などのデータ | 人名の値だけでは十分に補えない |
対策として、先頭30行の空欄、見出し語、値の形式、後続行の並びから表の開始位置を推定し、最大3段の見出しに対応しました。推定が違った場合に備えて、開始行と見出しの段数を手動で直せるようにもしています。
人名の判定には、姓名の区切り、文字種、少数の姓の手がかりなどを追加しました。判定根拠と「要確認」の表示を設け、自動判定をそのまま信じなくても修正できるようにしました。
なお、メールや電話番号などは以前から全行を検査していました。今回の問題は、「データを走査していなかった」ことではありません。表の構造を読み取る処理と、人名を判断する根拠が足りなかったことでした。
修正後、提供された表では9件の氏名が置換され、成績部分の値が変わっていないことを確認しています。出力Excelの内部XMLも調べ、元の氏名が残っていないことを確認しました。回帰テストには架空データを使い、実データはリポジトリや公開素材に入れていません。この結果は、その表での確認であり、未知の帳票すべてに対する検出精度の証明ではありません。
暗号化していても、対応表を取り違えると別人に戻る
もう一つの問題は復元でした。初期の記号はPERSON_001のような形式で、異なるファイルでも同じ記号が発生しました。ファイルAのAI回答にファイルBの対応表を使うと、別人の名前へ戻してしまいます。
対応表の暗号化は、元の情報をそのまま保存しないために必要です。しかし、暗号化だけでは「この回答に、この対応表を使ってよいか」は分かりません。
そこで、保存のたびにランダムな出力識別子を発行し、記号と暗号化した対応表の両方に含める形式へ変更しました。識別子が一致しない記号は復元せず、不一致を知らせます。同じ入力を保存し直しても、新しい識別子になります。
現在の記号はPERSON_(32桁の識別子)_001のような構成です。これは形式の説明で、実際の記号では括弧内が32桁の大文字16進数になります。AIの回答から復元するときは、記号を短縮・編集せず使う必要があります。
対応表には元の情報が入っています。AIへ渡すものではなく、端末内で回答を戻すために保管するものです。識別子は対応表の取り違えを検出する仕組みで、AIの回答内容そのものの正しさを保証するものではありません。
会社名や案件名は、文字の形だけでは機密と判断できない
v0.4.0では、会社・組織名にも対応を広げました。「会社名」「取引先」「勤務先」などの列名や、「株式会社」「LLC」などの値の形式を保護候補として扱います。
案件名、契約番号、給与、人事評価、原価、診断名なども、明示的な列名から候補にします。ただし、文字列だけで「その会社にとって機密か」を完全には判断できません。
そのため、利用者が隠したい語句を指定する機能を追加しました。指定語は全シートのセルと列名を検査し、一致したセルは取りこぼしを避けるためセル全体を置換します。指定した語句は自動保存しません。
この処理は、一致箇所だけを切り抜くものではありません。例えば案件名を含む備考が対象になれば、備考のセル全体が置換されます。残したい分析情報が同じセルに入っていないか、結果を確認する必要があります。
「端末内で処理する」を、実装と検証でも確かめる
ファイル処理はWeb Workerで実行し、外部通信を制限するCSPを設定しました。アクセス解析タグ、広告、外部フォント取得、ファイルや対応表の自動ストレージ保存は追加していません。対応表の暗号化にはWeb Crypto APIを使います。
出力は値から作り直し、元のコメント・リンク・画像・書式を引き継ぎません。数式は保存済みの計算結果を使います。元のExcelの見た目や数式をそのまま保つ編集ツールとは用途が異なるので、出力内容の確認は必要です。
開発時には、ページの読み込み後に通信を切った状態で、処理や保存などの主要操作を検証しました。ただし、サイトを最初に表示する通信は必要で、配信サービス側のアクセスログもあります。説明する範囲は「読み込んだファイルの処理は端末内で完結する」です。
v0.4.0公開時点で、処理系42件とブラウザ操作13件、計55件のテストが通過しています。公開サイトの主要操作も確認しました。第三者によるセキュリティ監査や認証を受けた、という意味ではありません。
公開までに整えたものと、まだ確認できていない成果
主な構成はReact、TypeScript、Viteです。Excel処理にはSheetJS、CSV処理にはPapaParseを使い、GitHubで管理してVercelへ公開しました。データベースやAI APIは使っていません。
入力上限は当初の10MBから25MBへ広げました。同時に、展開後の容量、行・列・セル数、処理時間にも制限を設けています。ファイルの容量だけで、端末の負荷を判断しないようにしました。
開発環境では、架空の30万セルのCSVを読み込み、判定・変換してExcelへ出力する処理が約1秒でした。Node環境の参考値で、ブラウザの描画時間は含みません。すべての端末で同じ速度になるとはいえません。
公開URLはmasksheet.katasuke-web.comです。Xserver側のDNS設定とVercel側の登録を行い、以前のVercel公開URLから転送するようにしました。同じように作品のURLを整えたい方は、サブドメインをVercelへ接続する手順を参考にできます。
日本語・英語のトップと使い方ガイド、タイトル・説明文、canonical、hreflang、サイトマップ、OG画像を整え、初期画面はビルド時にHTML化しました。無料ソフトとしての構造化データ、Search Consoleの所有権確認用タグ、固定のサイトURLを共有する案内とX投稿用の素材も用意しています。
これは実施した施策の記録です。検索順位や利用者数の増加は、まだ確認できていません。Google側での所有権確認完了や、実際の投稿状況も別途確認が必要です。
また、利用者向けの全機能無料という方針と、ドメイン代などを含む実際の総運営費は別です。独自ドメインを検討するときの費用の見方は、無料URLとの違い・ドメインの選び方と更新費用にまとめています。
まずは架空データで、どこが変わるか確認してほしい
MaskSheetでは、実装した機能を無料で提供する方針にしました。当初の有料版構想は採用していません。自分のファイルを使う前に、サンプルで「何が置き換わり、何が残るか」を確認できます。
自動検出には漏れと誤検出があります。自由文の人名や複雑な帳票、複数情報の組み合わせによる再識別には限界があります。PDF・Word、高度なローカルAI検出、デスクトップ版は未実装です。名前を隠しただけで、どんなデータでもAIに送ってよいと判断できるものではありません。
保持した値と列名を見直し、使うAIサービスのデータの扱いや所属組織の規程を確認してください。法令上の匿名加工情報になることや、法令への適合を保証するツールではありません。
使い方とデータの取り扱いのガイドも用意しています。不具合や改善案は、問い合わせフォームへ、実ファイルや個人情報を添付せず、操作内容を知らせてもらえると助かります。